


Kompetensdatan fungerar inte. Men inte av den anledning du tror
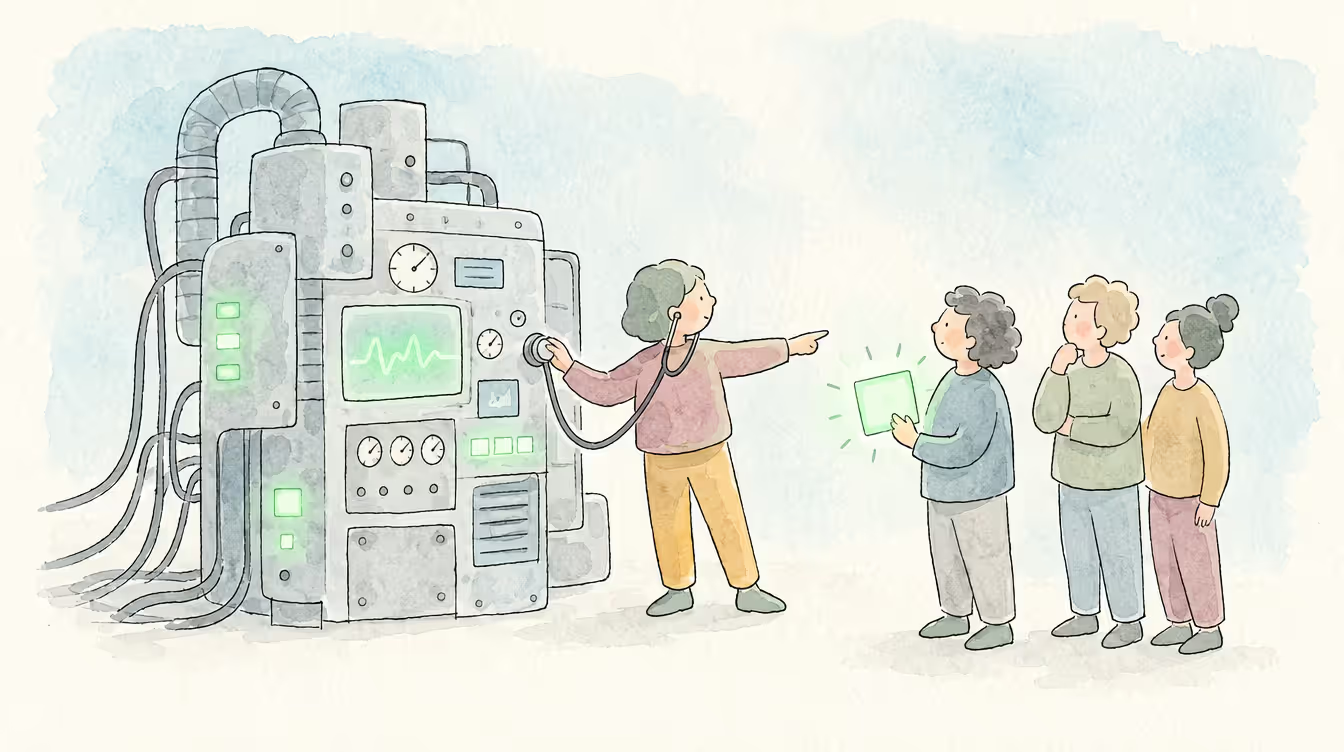
De flesta organisationer saknar en tillförlitlig bild av vad medarbetarna faktiskt kan. Kompetensdatan är ofullständig och inaktuell, och de som ska agera på den litar sällan på den. Strategiska beslut fattas på gissningar. Intern talang förblir oupptäckt. Investeringar i kompetensutveckling och lärande går till problem som kanske inte finns, eller förbi dem som faktiskt finns.
Det här är knappast en kontroversiell iakttagelse. Enligt Gartner har bara 8 % av organisationerna tillförlitlig data om vilka kompetenser medarbetarna har i dag. Åtta procent. Övriga 92 % famlar mer eller mindre i dimma.
Frågan är varför. Och ännu viktigare: vad som faktiskt löser det.
Receptet som branschen fortsätter att skriva ut
Det dominerande svaret är i allt högre grad bättre teknik. Närmare bestämt AI-baserade inferensmotorer som härleder kompetenssignaler ur befintliga arbetssystem: mejl, projektverktyg, prestationshistorik, lärplattformar och befattningsarkitekturer. Logiken är enkel. Om människor ger opålitlig kompetensdata är lösningen att samla in den utan att fråga dem. Ta bort den mänskliga variabeln. Låt systemet observera beteenden och dra slutsatser om förmåga.
Angreppssättet har verklig analytisk trovärdighet. Det ger sofistikerade resultat. Det integreras med de HR-plattformar som stora organisationer redan använder. Och det känns som ett seriöst svar på ett seriöst problem.
Men det hoppar över ett steg, och ett viktigt sådant.
Frågan som ingen ställer
Innan man accepterar att självrapporterad kompetensdata till sin natur är opålitlig är det värt att fråga varför den är opålitlig. Inte som ett retoriskt grepp, utan som en uppriktigt undersökande fråga.
Det är här frågan blir intressant. Enligt Deloittes forskning om kompetensbaserade organisationer säger 79 % av medarbetarna att de är öppna för att dela sin kompetensdata. Sjuttiotre procent säger att kompetensbaserade arbetssätt skulle förbättra deras upplevelse på jobbet. Viljan finns. Medarbetare håller i regel inte inne med information och gör inte motstånd.
Ändå har bara 8 % av organisationerna tillförlitlig kompetensdata.
Just det glappet, mellan medarbetarnas vilja och organisationens datakvalitet, är värt att titta närmare på. Det pekar åt ett annat håll än ”vi behöver bättre inferensteknik”. Det som är trasigt är relationen mellan människan och verktyget, inte människan själv.
Vad som faktiskt går fel
Det finns tre specifika skäl till att självrapporterad kompetensdata fallerar, åtminstone är det dessa vi ser gång på gång. Inget av dem handlar om den mänskliga naturen.
Det första är att de flesta kompetensverktyg är byggda för att tjäna organisationen, inte medarbetaren. De är system för datainsamling. Medarbetaren är indata. Det finns ingen synlig motprestation: ingen tydlighet kring karriären, ingen signal om hur profilen påverkar vilka uppdrag man matchas mot, ingen bild av den egna utvecklingsvägen. Den rationella reaktionen på ett verktyg som tar men aldrig ger något tillbaka är att göra det minsta möjliga, eller ingenting alls.
Det andra är avsaknaden av social ansvarsskyldighet. När en kompetensprofil ligger i ett HR-system som bara HR kan se finns ingen naturlig mekanism för självkorrigering. Du kan påstå dig vara expert på vad som helst. Du kan låta en profil stå orörd i ett år. Inte för att människor är oärliga, utan för att ärligheten saknar strukturellt stöd. Överdrifter får inga konsekvenser och korrekthet belönas inte.
Det tredje är att själva upplevelsen av att fylla i en kompetensprofil länge har varit utformad för regelefterlevnad, inte för engagemang. Långa taxonomier. Klumpiga gränssnitt. Ingen direkt återkoppling. Kompetensverktyg har byggts som utläggsblanketter: något att stå ut med, beta av och glömma.
Rätta till de här tre sakerna, så slutar människan vara problemet. Och till er som fortfarande tvivlar: ja, en del kommer ändå att överdriva. Men fundera på hur stort det felet kan bli som mest. Den som överdriver sina Python-kunskaper jobbar tillsammans med kollegor som ser hur hen arbetar. Glappet blir synligt. Datan rättar sig själv. Jämför det med inferensfel, som kommer förklädda till objektiva fakta, som ingen behöver stå till svars för inför andra och som i det tysta växer sig större med tiden. Frågan har aldrig varit om självrapporterad data är perfekt. Frågan är om felen är sådana man kan se och rätta till, eller sådana man inte kan.
Kompetensverktyg har byggts som utläggsblanketter: något att stå ut med, beta av och glömma.
Det finns ett fjärde problem, specifikt för inferensbaserade angreppssätt, som förtjänar en egen granskning.
AI-inferens bygger på att skanna signaler från befintliga system: mejlaktivitet, projektverktyg, lärplattformar, anställningshistorik och prestationsdata. Det outtalade antagandet är att det som syns i systemen speglar vad människor faktiskt kan och klarar av. Så är det inte.
Det här är vad inferens inte kan se. En nyanställd som började för tre månader sedan har ännu inga dataspår, så systemet har inget att dra slutsatser från. Certifikat som tagits före anställningen, eller utanför företagets system, förblir osynliga om ingen laddar upp dem manuellt. Mjuka färdigheter, omdöme som bygger på relationer, förmågan att läsa av ett rum eller hantera en besvärlig intressent: inget av detta lämnar spår i systemen. Kompetenser som finns men inte används just nu ger ingen signal alls.
Men det tydligaste exemplet är vad inferensen kommer fram till om två produktchefer med helt olika förmåga. Den oerfarna är väldigt aktiv i systemen. Hen släcker bränder hela tiden: skickar fler meddelanden, skapar fler ärenden, loggar fler problem och hör av sig oftare, eftersom hen kommunicerar fel och sedan får rätta till det. Den erfarna gör det mesta av sitt arbete genom samtal, omdöme och relationer. Problemen löses innan de når systemet. Hen genererar mindre data, inte mer. En inferensmotor som tränats på systemaktivitet skulle troligen dra slutsatsen att juniorn har bättre kompetens inom produktledning. Motorn har sett mer produktledning. Men den har sett fel saker.
De talanger som lämnar minst spår i era system är ofta era skickligaste experter, eftersom expertis förändrar själva sättet arbetet utförs på.
Det här är inget kalibreringsproblem som bättre algoritmer kommer att lösa. Det är en strukturell brist. De mest erfarna personerna i en organisation är ofta de som syns minst i systemen, just för att expertis innebär att man lägger mindre tid på att släcka bränder som syns som data. Vissa inferenssystem försöker hantera detta genom att skicka föreslagna kompetenser till medarbetare eller chefer för validering, en mänsklig kontroll av maskinens slutsatser. Det är en rimlig lapp på hålet. Men det innebär fortfarande att en människa ska rätta ett system som utgick från fel signal. Grunden är densamma.
Det här får en följd som de flesta organisationer inte räknar med. När ni förlitar er på inferens för att få syn på förmåga missar ni inte bara vad människor kan, ni underskattar det systematiskt. De kompetenser som är svårast att se är ofta de mest värdefulla. De talanger som lämnar minst spår i era system är ofta era skickligaste experter, eftersom expertis förändrar själva sättet arbetet utförs på.
Det tydligaste beviset finns i siffrorna
De mest sofistikerade inferensbaserade kompetenssystemen, djupt integrerade med HR-plattformar för storföretag och byggda på exakt den logik som beskrivs ovan, löser inte problemet med användningsgraden. Användningsgraden för HR-teknik i storföretag överstiger sällan 20 %. Tekniken fungerar som den är tänkt. Dataproblemet den skulle lösa finns kvar. Eftersom relationen mellan medarbetare och system aldrig lagades byggde man runt den i stället. Och att bygga runt en trasig grund är inte detsamma som att laga den.
Två implementeringar visar vad en annan grund ger.
Höegh Autoliners är ett globalt rederi med en mycket utspridd personalstyrka på fartyg, i hamnar och på kontor världen över. När de införde MuchSkills utgick de från principen att medarbetaren kommer först: varje medarbetare kunde tydligt se sin egen kompetensprofil, jämföra sig med roller de siktade mot och förstå glappet mellan var de befann sig och vart de ville. Organisationen krävde inte löpande uppdateringar, utan utformade ett verktyg som gjorde uppdateringarna värda besväret. Resultatet blev en aktiv användningsgrad på över 90 % i hela personalstyrkan, bibehållen över tid, i en bransch som historiskt inte förknippas med digital entusiasm. Deras kompetensdata är i dag så korrekt, och så betrodd, att den ingår i den årliga strategirapporteringen till styrelsen. Styrelsen använder den för att ställa, och besvara, frågan om organisationen har den förmåga som krävs för att genomföra sina planer.
Skala bevisar något annat. I slutet av 2025 levererade MuchSkills teknikplattformen för Project PASGA, den nigerianska federala regeringens personalrevision och kompetensgapsanalys, som genomfördes på plats av Phillips Consulting. Nästan 55 000 statstjänstemän vid 46 ministerier genomförde en strukturerad kompetensbedömning på tre månader: 5,1 miljoner kompetensposter, 4 800 certifikat och 19 000 utvecklingsmål. I genomsnitt registrerades 70 kompetenser per medarbetare. Det var ett statligt program, och deltagande förväntades. Ändå gick medarbetarna långt utöver miniminivån. De satte utvecklingsmål som ingen hade bett dem om, registrerade certifikat på eget initiativ och utforskade funktioner som de aldrig blivit ombedda att använda. I en statsförvaltning med 55 000 personer kommer sådant inte från ett direktiv. Det kommer från en utformning som fick deltagandet att kännas meningsfullt. Ett resultat i datan har stannat kvar hos oss: kompetensnivåerna i hela personalstyrkan var betydligt högre än cheferna hade trott. Förmågor som varit osynliga för organisationen, och för medarbetarna själva, blev synliga för första gången när människor fick ett genomtänkt sätt att visa vad de faktiskt kunde. Problemet var aldrig att förmågan saknades. Det var att metoderna för att synliggöra den bara kunde se en bråkdel av det som fanns.
Skillnaden mellan en användningsgrad under 20 % och en bibehållen användningsgrad på över 90 % ligger inte i hur sofistikerad den underliggande tekniken är. Den ligger i svaret på en fråga som kommer före: vems verktyg är det här, och vem tjänar det?
Så ser lösningen ut
Om problemet handlar om design och incitament ser lösningen också annorlunda ut.
Synlighet bland kollegor fungerar som en mekanism för datakvalitet, inte som en social funktion. När kompetensprofiler är synliga för kollegor sker självkorrigering naturligt. Ingen påstår sig vara expert bredvid en verklig expert. Ingen låter en profil bli inaktuell när kollegorna kan se den. Oberoende forskning med 27 000 medarbetare bekräftar detta. Transparens visar sig vara den mest tillförlitliga mekanismen för datakvalitet som finns, inte för att den övervakar människor, utan för att den tar bort de förutsättningar under vilka felaktigheter känns bekväma. Det är grundprincipen bakom MuchSkills metodik.
Att fånga motivation vid sidan av förmåga vänder helt på incitamenten. Om en plattform registrerar inte bara vad någon kan utan också vad hen vill göra, alltså vilket arbete hen tycker är meningsfullt och vilka kompetenser hen vill utveckla, handlar det inte längre om regelefterlevnad att fylla i sin profil. Det blir ett sätt att driva sin egen sak. Medarbetaren har något att vinna. Att vara korrekt är inte längre en tjänst åt organisationen utan något man gör för sin egen skull.
Design som vinner användarna i stället för att kräva att de är med spelar större roll än man kan tro. En skala för kunskapsnivå som tar 15 till 30 minuter att fylla i, som känns ärlig snarare än byråkratisk och som direkt visar medarbetarna vad de är värda, hur deras kompetenser står sig mot de roller de är intresserade av och vilka gap de kanske vill täppa till, ger en helt annan sorts engagemang. Inte tack vare förändringsprogram eller obligatoriska krav på ifyllnad. Utan för att produkten är värd det.
När alla tre samverkar blir resultatet kompetensdata som uppdateras löpande, inte för att medarbetarna blir tillsagda att uppdatera den, utan för att de vill. Det är ett i grunden annorlunda fundament att bygga på.
Den djupare filosofiska skillnaden
Skillnaden mellan de två angreppssätten handlar egentligen inte om metodik. Den handlar om vem kompetensdatan tillhör och vem den i första hand är utformad för att tjäna.
Det dominerande ramverket behandlar kompetenser som organisatoriska tillgångar. De ska fångas in, styras, taxonomiseras och integreras i HR-system. Medarbetaren är källan. Organisationen är ägaren. All designinsats läggs på att göra insamlingen effektivare och inferensen mer träffsäker. Medarbetaren förekommer knappt alls i produktupplevelsen.
Det går inte att härleda sig fram till data som aldrig fanns.
Vänd på relationen så förändras något i grunden. När plattformen tjänar medarbetaren först, när den tydligt visar deras egna förmågor, signalerar vilket arbete de är bäst lämpade för och speglar den utveckling de gör, blir korrekt och aktuell data en naturlig biprodukt av deras eget intresse av att hålla den uppdaterad. Ni behöver inte bygga runt människan. Människan blir er mest motiverade och mest tillförlitliga datakälla.
Det här är inget luddigt påstående om kultur eller värderingar. Det är ett produktdesignargument med mätbara konsekvenser för datakvalitet och användningsgrad. De 79 % av medarbetarna som säger att de är villiga att dela sin kompetensdata är inte problemet. Frågan är om verktygen de får gör den viljan värd att agera på.
En annan utgångsfråga
Teknik som bygger på fel mänsklig grund kommer alltid att prestera sämre än teknik som bygger på rätt grund. De 92 % av organisationerna som fortfarande saknar tillförlitlig skills intelligence saknar inte alla tillgång till bättre inferensmotorer. Många har dem redan. Det de saknar är en annan utgångsfråga.
Branschen frågar: hur får vi bättre kompetensdata?
Den mer användbara frågan är: varför skulle en medarbetare över huvud taget ge oss korrekt kompetensdata?
Besvara den på ett annat sätt, genom design, genom transparens, genom verktyg som verkligen tjänar den som fyller i dem, så förändras allt som följer. Datan blir bättre. Användningen följer. Och glappet mellan vad organisationer tror att deras medarbetare kan och vad de faktiskt kan börjar äntligen att krympa.
Inget av detta är ett argument mot AI inom skills intelligence. AI-inferens ovanpå högkvalitativ data som medarbetarna själva har genererat är en kraftfull kombination. Problemet är att de flesta organisationer försöker hoppa över grunden och gå direkt till lagret ovanpå. Det går inte att härleda sig fram till data som aldrig fanns.
Mer teknik är inte alltid lösningen. Ibland handlar det om design.
Om du känner igen dig i resonemanget beror det på att MuchSkills är byggt på just den grunden: medarbetaren först, organisationen sedan. Boka en demo och se hur kompetensdata ser ut när designen är rätt. Eller hör av dig till oss och se själv.
Vanliga frågor
Hittar du inte svaret här? En riktig person svarar, oftast samma arbetsdag.
Alla frågor finns i FAQ:nÄr inte AI-inferens mer objektiv än att låta medarbetarna bedöma sig själva?
Inferensbaserade system framstår som mer objektiva eftersom de tar bort medarbetaren från datainsamlingen. Men de ärver de snedvridningar som redan finns i de system de hämtar signaler från: befattningstitlar, mejlmönster och projekthistorik. Dessa speglar vad medarbetarna har fått i uppdrag att göra, inte nödvändigtvis vad de kan eller vill göra härnäst. Självrapporterad data som samlas in via ett genomtänkt system med inbyggd social ansvarsskyldighet fångar en annan och ofta mer användbar signal: vad medarbetarna vet att de kan och är motiverade att bidra med.
Vad hindrar medarbetare från att överdriva sina kompetenser, även på en genomtänkt plattform?
Den viktigaste spärren är att kollegorna kan se profilerna. När kompetensprofiler är synliga för kollegor känns det obekvämt att utge sig för att vara expert på något som de kan bedöma, något man aldrig behöver känna inför en privat HR-databas. Oberoende forskning bland 27 000 medarbetare visade att öppenhet minskar överdrifterna avsevärt, inte för att folk övervakas utan för att det sociala sammanhanget förändrar kalkylen. Människor är i regel ärligare när det de påstår kan ses och bedömas av personer som känner till deras arbete.
Innebär medarbetarfokuserad design att organisationen förlorar kontrollen över sin kompetensdata?
Nej, det innebär att organisationen får bättre data just för att den släpper skenet av kontroll. När medarbetarna äger sina profiler och upplever dem som verkligt användbara håller de dem aktuella utan att någon behöver be om det. Organisationen får en mer korrekt, mer fullständig och mer betrodd bild av medarbetarnas förmåga än vad ett obligatoriskt insamlingssystem normalt ger. Kontroll över datainmatningen ger inte datakvalitet. Det gör rätt incitamentsstruktur.
Hur ofta bör kompetensdata uppdateras?
I de flesta organisationer ger årliga kompetensgenomgångar data som redan är inaktuell när besluten fattas utifrån den. Den mer användbara frågan är vad som får medarbetarna att vilja uppdatera sina profiler löpande: att uppdateringen gynnar dem direkt. Om en kompetensprofil påverkar vilka projekt någon matchas mot, vilka utvecklingsmöjligheter som lyfts fram för hen eller hur ens utveckling syns för chefen, hålls den aktuell helt naturligt. Obligatoriska uppdateringscykler är en nödlösning för en plattform som inte har förtjänat ett varaktigt engagemang.
Hur är det med AI som härleder kompetenser ur CV:n och prestationsbedömningar i stället för ur löpande systemaktivitet?
Vissa inferensmetoder hämtar data från strukturerade dokument, som CV:n, prestationsbedömningar, rekryteringsdatabaser och register över genomförda utbildningar, snarare än från beteenden i arbetssystemen. Datakällorna skiljer sig åt, men den grundläggande begränsningen är densamma: inferens kan bara synliggöra det som redan är dokumenterat. En senior produktchef vars expertis tar sig uttryck i omdöme, relationer och i att förebygga problem innan de uppstår blir underdokumenterad med båda metoderna. CV:t speglar titel och anställningstid. Prestationsbedömningen speglar det som chefen lade märke till. Ingen av dem fångar förmåga som aldrig behövde skrivas ner eftersom den redan fungerade. Inferensmotorn läser det som finns. Det mest värdefulla är ofta det som lämnar minst spår.
Vill du se vad dina team klarar av?
MuchSkills samlar kompetensen som finns utspridd i CV:n, kalkylblad och människors huvuden i en levande karta. Då bygger beslut om bemanning, planering och utveckling på fakta i stället för gissningar.